Gradient Boosting Explained from Scratch
From Theory to Practical Examples

1. Mở đầu
Trong thời đại dữ liệu ngày càng lớn và phức tạp, Machine Learning trở thành công cụ mạnh mẽ giúp dự đoán, phân loại và ra quyết định thông minh. Một trong những thuật toán cơ bản và phổ biến là Decision Tree (DT), dễ hiểu và trực quan, nhưng thường overfit dữ liệu và khó tổng quát hóa.
Để cải thiện, các phương pháp ensemble như Random Forest (RF) và AdaBoost ra đời:
Random Forest giảm overfitting bằng cách kết hợp nhiều cây ngẫu nhiên, nhưng vẫn bỏ qua mối quan hệ giữa các cây trong quá trình học.
AdaBoost tập trung vào các mẫu khó, cải thiện độ chính xác, nhưng nhạy cảm với outlier và có thể dễ overfit nếu dữ liệu nhiễu.
Những hạn chế này đặt ra động lực cho Gradient Boosting – một kỹ thuật mạnh mẽ kết hợp ensemble và tối ưu hóa hàm mất mát theo gradient, vừa duy trì tính linh hoạt của cây quyết định, vừa cải thiện hiệu năng tổng quát hóa trên dữ liệu phức tạp.
Trong blog này, chúng ta sẽ cùng “mổ xẻ” Gradient Boosting từ cơ bản đến nâng cao, minh họa bằng tính toán tay, bảng dữ liệu mẫu, và code Python, để hiểu rõ cơ chế hoạt động và cách triển khai thực tế.
2. Nền Tảng Decision Tree, Random Forest và AdaBoost: Bước Đệm Cho Gradient Boosting
Trong số các thuật toán ensemble dựa trên Decision Tree, Gradient Boosting được coi là một trong những phương pháp mạnh mẽ nhất. Để hiểu vì sao Gradient Boosting hiệu quả, trước hết chúng ta cần nhìn lại cơ chế của Decision Tree, Random Forest và AdaBoost – ba nền tảng quan trọng giúp hình thành ý tưởng cho Gradient Boosting.
Trong lĩnh vực học máy, Decision Tree (DT) là một trong những mô hình cơ bản nhưng vô cùng trực quan. Ý tưởng của cây quyết định khá đơn giản: mô hình đặt ra những câu hỏi tuần tự dựa trên đặc trưng của dữ liệu (ví dụ “giá trị này có lớn hơn ngưỡng X không?”) để chia nhỏ tập dữ liệu thành các nhánh, cho đến khi đi tới các nút lá và đưa ra dự đoán. Cây quyết định có ưu điểm là dễ hiểu, dễ giải thích, và có thể nắm bắt được mối quan hệ phi tuyến tính giữa các biến. Tuy nhiên, một cây đơn lẻ thường có độ sâu hạn chế để tránh quá phức tạp, hoặc ngược lại nếu quá sâu thì dễ overfit, khiến mô hình không tổng quát tốt trên dữ liệu mới. Điều này làm cho DT tuy trực quan nhưng thiếu tính ổn định.
Để cải thiện nhược điểm này, Random Forest (RF) ra đời. Thay vì chỉ dựa vào một cây duy nhất, Random Forest tạo ra hàng trăm thậm chí hàng ngàn cây quyết định. Mỗi cây trong rừng được huấn luyện trên một mẫu con (bootstrap sample) của dữ liệu ban đầu, đồng thời tại mỗi nút phân chia, chỉ một tập con ngẫu nhiên của đặc trưng được xét đến. Cách làm này giúp các cây trở nên đa dạng và giảm tương quan lẫn nhau. Khi dự đoán, kết quả được tổng hợp lại (lấy trung bình cho hồi quy hoặc bỏ phiếu cho phân loại), từ đó tăng tính ổn định và giảm nguy cơ overfit. Random Forest mạnh mẽ hơn hẳn một Decision Tree, nhưng bản chất của nó là bagging -nên chúng không học hỏi từ sai lầm của nhau. Vì vậy, tuy ổn định, nhưng đôi khi Random Forest thiếu khả năng tinh chỉnh chi tiết trên các mẫu khó.
Đó là lý do boosting xuất hiện, trong đó AdaBoost (Adaptive Boosting) là một trong những kỹ thuật đầu tiên và nổi bật. Khác với bagging, boosting huấn luyện nhiều mô hình một cách tuần tự. Ở AdaBoost, ban đầu tất cả các mẫu dữ liệu đều có trọng số như nhau. Sau khi mô hình (thường là một cây nông – weak learner) được huấn luyện, những mẫu bị dự đoán sai sẽ được gán trọng số cao hơn. Mô hình kế tiếp sẽ tập trung nhiều hơn vào các mẫu này để “sửa sai” cho mô hình trước. Quá trình này lặp lại nhiều lần, và kết quả cuối cùng là sự kết hợp có trọng số của tất cả các mô hình con. Ưu điểm của AdaBoost là có thể cải thiện độ chính xác đáng kể so với một cây đơn lẻ, nhưng nhược điểm là quá nhạy cảm với nhiễu và outlier – vì những điểm dữ liệu “khó” có thể bị gán trọng số quá cao, khiến toàn bộ mô hình bị ảnh hưởng.
Từ những hạn chế này, Gradient Boosting (GB) được phát triển như một bước tiến vượt bậc. Giống AdaBoost, Gradient Boosting cũng là một phương pháp boosting tuần tự, nhưng thay vì chỉ điều chỉnh trọng số dựa trên lỗi phân loại, Gradient Boosting coi quá trình này như một bài toán tối ưu hóa hàm mất mát. Mỗi mô hình con mới được huấn luyện để dự đoán residuals – tức phần sai số còn lại của mô hình trước đó. Nói cách khác, Gradient Boosting “học” trực tiếp từ những gì mô hình hiện tại chưa làm tốt, và liên tục cập nhật theo hướng giảm gradient của hàm mất mát. Nhờ cơ chế này, Gradient Boosting vừa tận dụng được sức mạnh của boosting, vừa linh hoạt hơn trong việc xử lý nhiều loại bài toán khác nhau (phân loại, hồi quy, xếp hạng). Đây chính là nền tảng cho những thuật toán nổi tiếng sau này như XGBoost, LightGBM và CatBoost.
3. Gradient Boosting: Thuật toán, toán học và triển khai
Gradient Boosting là một trong những thuật toán machine learning hàng đầu cho dữ liệu bảng (tabular datasets), nổi bật với khả năng phát hiện mối quan hệ phi tuyến phức tạp giữa biến mục tiêu (target) và các đặc trưng (features).
Gradient Boosting vô cùng linh hoạt, có thể xử lý missing values, outliers, và các đặc trưng phân loại với cardinality cao mà không cần tiền xử lý phức tạp. Dù bạn có thể sử dụng các thư viện như XGBoost hay LightGBM để xây dựng mô hình Gradient Boosting mà không cần hiểu sâu, việc nắm rõ cơ chế hoạt động sẽ giúp bạn tối ưu hyperparameters, tùy chỉnh loss function, và nâng cao chất lượng mô hình đáng kể.
3.1. Gradient Boosting trong Regression
Trước hết, hãy xem Gradient Boosting hoạt động thế nào trong Regression. Thay vì cố gắng học toàn bộ quan hệ một lần, mô hình sẽ học dần từng bước, mỗi bước cố gắng sửa lỗi (residuals) của bước trước.
Để trực quan, chúng ta sẽ dùng một bảng dữ liệu nhỏ (tabular data mẫu) và minh họa tính tay 2 bước.
3.1.1. Ví dụ tính tay với tabular data mẫu
Giả sử nhé, chúng ta có bài toán dự đoán giá nhà (target) dựa vào các đặc trưng sau:
| Khu vực | Loại nhà | Số phòng | Giá nhà (nghìn $) |
| Trung tâm | Chung cư | 2 | 150 |
| Trung tâm | Biệt thự | 3 | 200 |
| Trung tâm | Penthouse | 4 | 250 |
| Ngoại ô | Chung cư | 2 | 130 |
| Ngoại ô | Biệt thự | 3 | 180 |
| Ngoại ô | Penthouse | 4 | 220 |
Trước khi tính tay, hãy nắm qua 3 bước cơ bản của Gradient Boosting trong Regression:
Dự đoán khởi đầu (tính trung bình giá nhà)
Tính residuals (lỗi giữa giá thực tế và dự đoán)
Huấn luyện cây tiếp theo để sửa lỗi và cập nhật dự đoán
Ở đây, chúng ta sẽ tạm thời bỏ qua ý nghĩa sâu xa của các công thức toán học. Mục tiêu là hiểu trực quan cách Gradient Boosting cải thiện dự đoán từng bước.
Đầu tiên, trong Gradient Boosting, cây đầu tiên super giản đơn, chỉ dự đoán trung bình target cho tất cả các dòng dữ liệu.
$$F_0(x) = \frac{150 + 250 + 130 + 180 + 220}{6} = 188.33$$
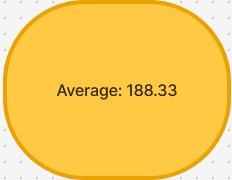
Lúc này, ta có thể hiểu rằng với bất kỳ giá trị mới nào, nếu dừng ở cây đầu tiên, dự đoán giá nhà sẽ luôn bằng 188.33. Nói cách khác, cây đầu tiên như kiểu một thầy bói lười, chỉ biết nói “Thằng này mai sau có như nào ra sao cũng chỉ m88 thôi” . Chúng ta cần thêm các cây tiếp theo để “sửa lỗi” và dự đoán chính xác hơn cho từng loại nhà.
Tiếp theo, ta tính residuals bằng cách lấy Giá thực tế trừ cho Dự đoán ban đầu \(F_0(x)\). Residual này còn được gọi là Pseudo Residual – một thuật ngữ xuất phát từ Linear Regression, nghĩa là sự khác nhau giữa giá trị thực tế và giá trị dự đoán.
Bạn có thể xem minh họa trong ảnh [link]
Từ công thức trên, ta sẽ có 1 bảng mới sau, thêm một cột cho phần residuals nhé:
| Khu vực | Loại nhà | Số phòng | Giá nhà | Dự đoán F₀ | Residual |
| Trung tâm | Chung cư | 2 | 150 | 188.33 | -38.33 |
| Trung tâm | Biệt thự | 3 | 200 | 188.33 | 11.67 |
| Trung tâm | Penthouse | 4 | 250 | 188.33 | 61.67 |
| Ngoại ô | Chung cư | 2 | 130 | 188.33 | -58.33 |
| Ngoại ô | Biệt thự | 3 | 180 | 188.33 | -8.33 |
| Ngoại ô | Penthouse | 4 | 220 | 188.33 | 31.67 |
Từ đây, ta sẽ xây cây thứ hai dựa trên residuals của cây đầu tiên. Nói cách khác, thay vì dự đoán giá nhà trực tiếp, cây mới sẽ học cách dự đoán residuals – tức là phần lỗi còn lại sau dự đoán trung bình. Ở đây, mình sẽ không đi sâu vào cách chia feature hay chọn feature tốt nhất, căn bản nó sẽ dựa trên residual, tính toán feature nào có MSE (Mean Squared Error) nhỏ nhất để chọn điểm chia.
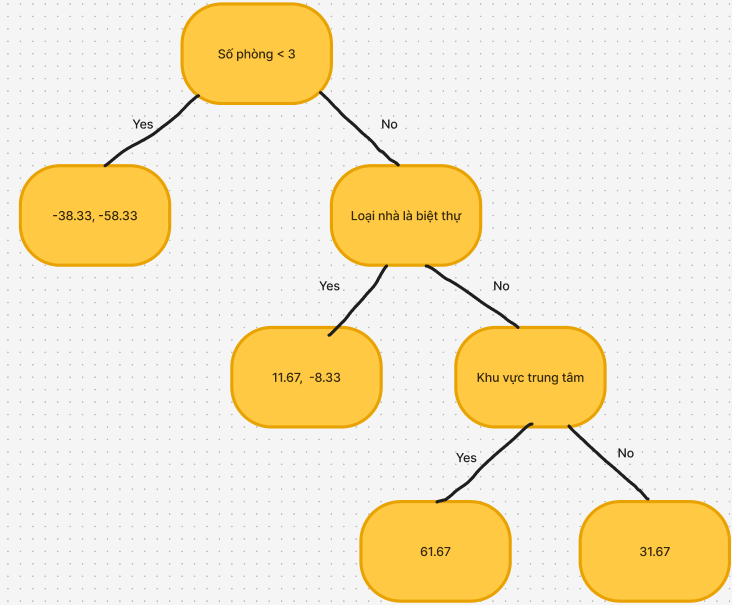
Sau khi xây cây thứ hai, bước tiếp theo là tính residual trung bình trong mỗi leaf node. Mỗi leaf node sẽ dự đoán residual trung bình, và từ đó chúng ta cập nhật dự đoán tổng thể \(F_1(x)\) cho từng nhóm nhà:
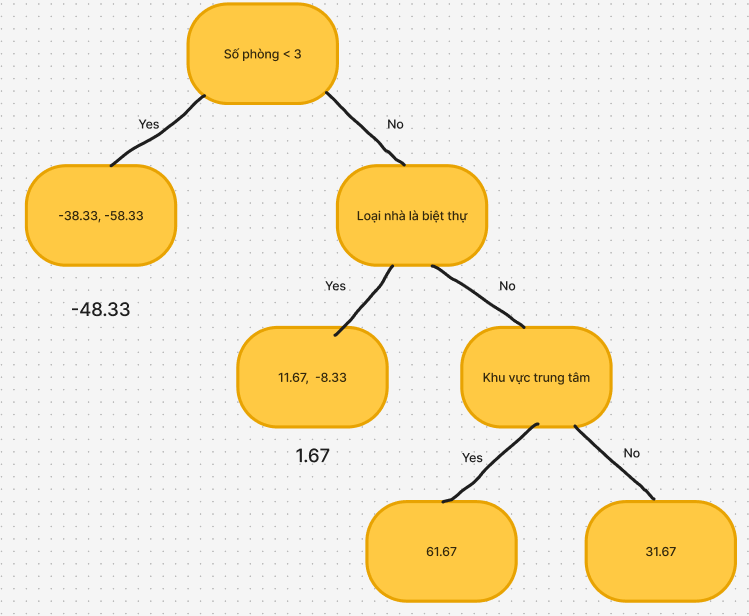
Sau khi xây cây thứ hai, ta có thể tính dự đoán mới bằng cách cộng trực tiếp dự đoán từ cây đầu tiên và residual trung bình từ cây thứ hai. Nếu bỏ qua learning rate, tức là update toàn bộ residual luôn, mô hình sẽ cố gắng sửa tất cả lỗi ngay lập tức, dẫn đến overfit – dự đoán quá khớp với dữ liệu huấn luyện, mất khả năng tổng quát cho dữ liệu mới.
Cứ cho là ta mặc kệ đi, bảng lúc này sẽ như sau:
| Loại nhà | Giá nhà | F0(x) | h₁(leaf) | F₁(x) = F₀(x) + h₁(leaf) |
| Chung cư | 150 | 188.33 | -48.33 | 140.00 |
| Biệt thự | 200 | 188.33 | 1.67 | 190.00 |
| Penthouse | 250 | 188.33 | 61.67 | 250.00 |
| Chung cư | 130 | 188.33 | -48.33 | 140.00 |
| Biệt thự | 180 | 188.33 | 1.67 | 190.00 |
| Penthouse | 220 | 188.33 | 31.67 | 220.00 |
Nhìn vào bảng, bạn có thể thấy \(F_1(x)\) đã khớp gần như hoàn toàn với Giá nhà thực tế. Đây chính là ví dụ điển hình của overfit – mô hình quá giống tập dữ liệu train, nhưng khả năng dự đoán với dữ liệu mới sẽ kém đi (low-bias vs high-variance).
Để tránh tình trạng này, Gradient Boosting sử dụng learning rate η (0 < η ≤ 1), tức là chỉ cập nhật một phần residual mới trong mỗi bước. Công thức cập nhật lúc này là:
$$F_i(x) = F_{i-1}(x) + η * h_i(x)$$
Ft(x): dự đoán tại bước t
ht(x): residual hoặc gradient do cây thứ t dự đoán
η: learning rate, kiểm soát tốc độ học của từng cây
Với cơ chế này, Gradient Boosting cập nhật dự đoán từng bước một cách thận trọng, vừa cải thiện độ chính xác, vừa giảm nguy cơ overfit.
Sau khi tính \(F_1(x)\) với learning rate η = 0.5, các dự đoán mới vẫn chưa khớp hoàn toàn với giá trị thực tế, nhưng nhờ learning rate, qua nhiều vòng lặp các dự đoán sẽ tiến dần về giá trị thực tế, thay vì cố gắng khớp quá nhanh và dẫn đến overfitting nếu không sử dụng learning rate:
| Loại nhà | Giá nhà | F₀(x) | Residual h₁(x) | h₁(leaf) | F₁(x) = F₀ + η*h₁(leaf) |
| Chung cư | 150 | 188.33 | -38.33 | -48.33 | 164.17 |
| Biệt thự | 200 | 188.33 | 11.67 | 1.67 | 189.17 |
| Penthouse | 250 | 188.33 | 61.67 | 61.67 | 219.67 |
| Chung cư | 130 | 188.33 | -58.33 | -48.33 | 164.17 |
| Biệt thự | 180 | 188.33 | -8.33 | 1.67 | 189.17 |
| Penthouse | 220 | 188.33 | 31.67 | 31.67 | 204.17 |
Tương tự các bước trên, ta tính được residual \(h_2(x)\) bằng cách lấy giá nhà thực tế trừ đi kết quả dự đoán sau cây thứ nhất \(F_1(x)\). Khi đó, ta thu được bảng kết quả sau:
| Loại nhà | Giá nhà | F₁(x) | h₁(x) | h₂(x) = y - F₁(x) |
| Chung cư | 150 | 164.17 | -38.33 | -14.17 |
| Biệt thự | 200 | 189.17 | 11.67 | 10.83 |
| Penthouse | 250 | 219.67 | 61.67 | 30.33 |
| Chung cư | 130 | 164.17 | -58.33 | -34.17 |
| Biệt thự | 180 | 189.17 | -8.33 | -9.17 |
| Penthouse | 220 | 204.17 | 31.67 | 15.83 |
Khi đã có \(h_2(x)\), ta tiếp tục quá trình giống như trước: dùng residual mới làm mục tiêu, huấn luyện cây tiếp theo, rồi cập nhật dự đoán \(F_2(x)\). Qua nhiều vòng lặp như vậy, mỗi cây lại sửa một phần lỗi còn sót lại của mô hình.
Điều quan trọng bạn cần nhớ là: mỗi vòng boosting không cố gắng học toàn bộ dữ liệu một lần nữa, mà chỉ học phần “chênh lệch” (residual) giữa giá trị thật và dự đoán hiện tại. Nhờ đó, mô hình vừa chính xác dần lên, vừa tránh việc quá khớp dữ liệu ngay từ đầu.
Đến đây, ta có thể tổng kết quy trình Gradient Boosting trong Regression:
Bắt đầu bằng dự đoán khởi tạo \(F_0(x)\).
Ở mỗi vòng lặp, tính residual dựa trên loss.
Huấn luyện cây mới \(h_i(x)\) để dự đoán residual đó.
Cập nhật mô hình bằng công thức:
$$F_i(x) = F_{i-1}(x) + η * h_i(x)$$
Lặp đi lặp lại, residual dần thu nhỏ, mô hình trở nên chính xác hơn.
3.1.2. Ý nghĩa toán học đằng sau
Sau khi đã hiểu qua Gradient Boosting hoạt động như thế nào qua các bước tính tay, bây giờ chúng ta cùng đi sâu hơn vào phần toán học. Việc chứng minh này sẽ giúp thấy rõ cách hàm mục tiêu được tối ưu dần qua từng bước boosting, cũng như lý do tại sao mô hình có thể cải thiện liên tục sau mỗi cây.
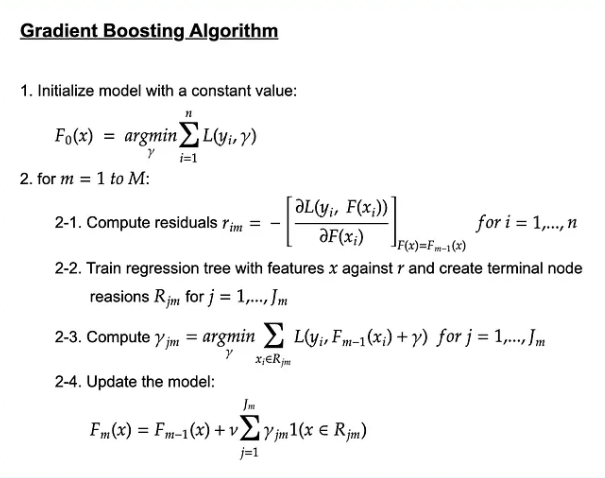
Nhìn có vẻ đao to bố lớn đúng không, giờ tôi sẽ đi từng bước nhé:
Bước 1:
$$F_{0}(x) = \arg\min_{\gamma} \sum_{i=1}^{n} L(y_i, \gamma)$$
Bước đầu tiên của Gradient Boosting là tạo ra một dự đoán hằng số ban đầu \(F_0\). Ở đây ta đang làm bài toán hồi quy, nên hàm mất mát $L$ được chọn là squared loss:
$$L(y_{i},γ) = (y_{i} - γ)^2$$
Dấu \(arg\min\) có nghĩa là ta đang tìm giá trị \(\gamma\) sao cho tổng loss trên toàn bộ dữ liệu nhỏ nhất, ta thay squared loss vào cho dễ nhìn nhé:
$$F_{0}(x) = \arg\min_{\gamma} \sum_{i=1}^{n} (y_i - {\gamma})^2$$
Để tìm \(\gamma\) tối ưu, ta lấy đạo hàm theo \(\gamma\) và đặt bằng 0:
$$\frac{\partial}{\partial \gamma} \sum_{i=1}^n (y_i - \gamma)^2 = 0$$
Ta triển khai đạo hàm như sau:
$$\begin{align} \frac{\partial}{\partial \gamma} \sum_{i=1}^{n} (y_i - \gamma)^2 &= \sum_{i=1}^{n} \frac{\partial}{\partial \gamma} (y_i - \gamma)^2 \\ &= \sum_{i=1}^{n} -2(y_i - \gamma) \\ &= -2 \sum_{i=1}^{n} y_i + 2 \sum_{i=1}^{n} \gamma \\ &= -2 \sum_{i=1}^{n} y_i + 2n\gamma \end{align}$$
Tiếp theo, ta đặt đạo hàm bằng 0 và tính ra nghiệm \(\gamma\):
$$\begin{align} 0 &= -2 \sum_{i=1}^{n} y_i + 2n\gamma \\ n\gamma &= \sum_{i=1}^{n} y_i \\ \gamma &= \frac{1}{n} \sum_{i=1}^{n} y_i \end{align}$$
Kết quả cho thấy \(\gamma\) chính là giá trị trung bình của các \(y_i\). Vì vậy, trong bài toán hồi quy với squared loss, dự đoán khởi tạo \(F_0\) của Gradient Boosting chính là giá trị trung bình của biến mục tiêu.
Giả sử ta chỉ lấy 3 mẫu đầu tiên trong bảng dữ liệu giá nhà:
\(y_1\)\=150
\(y_2\)\=200
\(y_3\)\=250
Hàm mục tiêu khi đó là:
$$\begin{align} G(\gamma) &= \tfrac{1}{2}(150 - \gamma)^2 + \tfrac{1}{2}(200 - \gamma)^2 + \tfrac{1}{2}(250 - \gamma)^2 \\ &= \tfrac{1}{2}\big[(150^2 - 300\gamma + \gamma^2) + (200^2 - 400\gamma + \gamma^2) + (250^2 - 500\gamma + \gamma^2)\big] \\ &= \tfrac{1}{2}(22500 + 40000 + 62500) - (300 + 400 + 500)\tfrac{\gamma}{2} + \tfrac{3}{2}\gamma^2 \\ &= 62500 - 600\gamma + \tfrac{3}{2}\gamma^2 \end{align}$$
Lấy đạo hàm và đặt bằng 0:
$$\begin{align} G'(\gamma) &= -600 + 3\gamma \\ 0 &= -600 + 3\gamma \\ \gamma &= 200 \end{align}$$
Kết quả đúng bằng trung bình cộng của 150, 200 và 250.
Bước 2
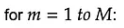
Tất cả quá trình của bước 2 này sẽ lặp lại bước làm với $M$ cây.
Bước 2 - 1
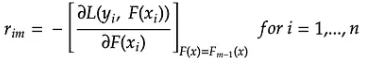
Ở đây:
\(\frac{\partial L(y_i, F(x_i))}{\partial F(x_i)}\) chính là đạo hàm của hàm loss
\(F_{m−1}(x)\) là mô hình dự đoán sau bước thứ \(m-1\)
\(r_{im}\) là residual (hay negative gradient) của điểm dữ liệu thứ i tại vòng boosting thứ m.
Nhưng tại sao lại có dấu trừ ở đây? Điều này liên quan đến bản chất của gradient. Gradient luôn chỉ ra hướng tăng nhanh nhất của loss. Nếu ta đi theo hướng gradient, loss sẽ tăng lên thay vì giảm – điều mà chúng ta không muốn khi tối thiểu hóa lỗi. Vì vậy, Gradient Boosting thông minh ở chỗ nó lấy ngược hướng gradient (thêm dấu “-”) để di chuyển về phía giảm loss. Đây là lý do tại sao dấu trừ xuất hiện, giúp thuật toán tiến gần hơn đến giá trị tối ưu.
Cụ thế, với squared loss:
$$L(y_i, F(x_i)) = \frac{1}{2} \big( y_i - F(x_i) \big)^2$$
Ta có đạo hàm:
$$\begin{equation} \frac{\partial L}{\partial F(x_i)} = - \big(y_i - F(x_i)\big) \end{equation}$$
Thay vào công thức residual:
$$\begin{equation} r_{i}^{(m)} = - \left[ \frac{\partial L(y_i, F(x_i))}{\partial F(x_i)} \bigg|{F = F{m-1}} \right] = y_i - F_{m-1}(x_i) \end{equation}$$
Nhờ dấu “–”, residuals trở thành công thức quen thuộc:
$$Residual = Observed - Prediction$$
Bước 2 - 2
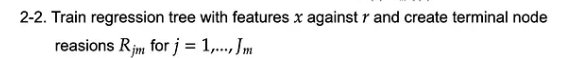
Ở đây, $j$ đại diện cho một nút lá (terminal node hay leaf) trong cây quyết định. Mỗi nút lá là kết quả cuối cùng của một nhánh cây, nơi dự đoán được thực hiện.
$m$ là chỉ số của cây (tree index), giúp phân biệt các cây khác nhau trong quá trình xây dựng mô hình. Vì Gradient Boosting kết hợp nhiều cây để cải thiện dự đoán, $m$ cho biết cây thứ mấy đang được sử dụng.
Cuối cùng, $J$ (viết hoa) biểu thị tổng số nút lá trong một cây. Đây là số lượng các nút cuối cùng mà cây tạo ra, ảnh hưởng trực tiếp đến độ phức tạp và khả năng biểu diễn của mô hình.
Bước 2 - 3
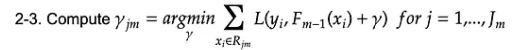
Sau khi xây một cây thứ $m$ lên các residual (hoặc gradient), ta cần gán một giá trị cố định \(\gamma_{jm}\) cho mỗi lá $j$ của cây sao cho tổng thiệt hại (loss) trên các mẫu thuộc lá đó là nhỏ nhất. Ký hiệu lá thứ $j$ của cây $m$ là \(R_{jm}\).
Giả sử chúng ta sử dụng squared loss – một hàm mất mát phổ biến trong bài toán hồi quy, áp dụng vào công thức trên:
$$y_{jm} = \arg\min_{\gamma} \sum_{x_i \in R_{jm}} (y_i - (F_{m-1}(x_i) + \gamma))^2$$
Đặt \(r_{im} = y_i - F_{m-1}(x_i)\) là residual (phần sai số hiện thời) của mẫu i. Ta triển khai bài toán tìm \(\gamma\) tối ưu như những phần trên:
$$\frac{\partial}{\partial \gamma} \sum_{x_i \in R_{jm}} (r_{im} - \gamma)^2 = -2 \;\;\;\;\Rightarrow \sum_{x_i \in R_{jm}} (r_{im} - \gamma) = 0 \;\;\;\;\Rightarrow\;\;\;\; n_j \, \gamma = \sum_{x_i \in R_{jm}} r_{im} \;\;\;\;\Rightarrow\;\;\;\; \gamma_{jm} = \frac{1}{n_j} \sum_{x_i \in R_{jm}} r_{im}$$
Mình sẽ lấy lại bảng và cây trên thay số cho dễ hiểu hơn nhé:
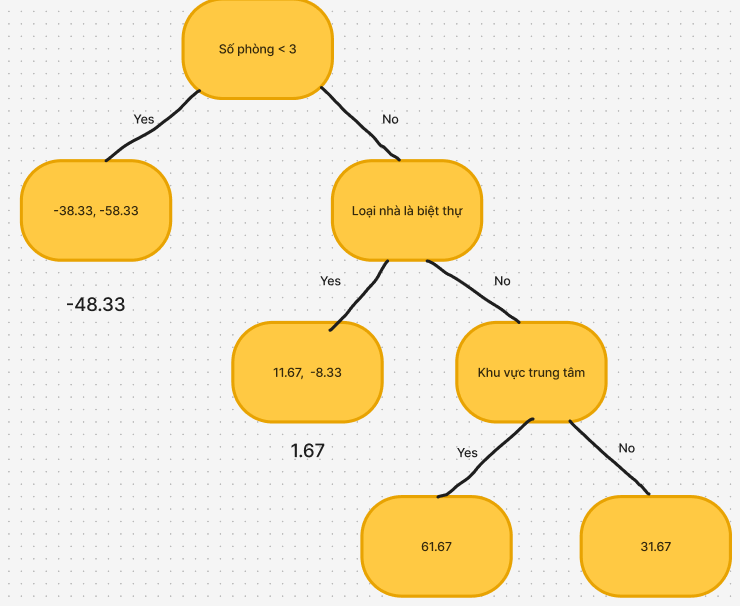
Ta thử thay số vào công thức ở bước 2 - 3 cho lá có 1 mẫu và lá có 2 mẫu nhé. Ở phần lá có 1 mẫu, mình chọn node “Khu vực trung tâm”, Giá nhà là $250$, và \(F_0(x)\) = $188.33$:
$$\begin{align*} y_{31} &= \arg\min_{\gamma} \left[ \frac{1}{2} (250 - (188.33 + \gamma))^2 \right] \\ &\rightarrow y_{31} = \arg\min_{\gamma} \left[ \frac{1}{2} (250 - 188.33 - \gamma)^2 \right] \\ &\rightarrow y_{31} = \arg\min_{\gamma} \left[ \frac{1}{2} (61.67 - \gamma)^2 \right] \\ &\rightarrow \gamma = 61.67 \end{align*}$$
Tiếp đến, phần lá có 2 mẫu, ta cũng triển khai tương tự, ở đây tôi sẽ lấy lá \(y_{21}\) với residual lần lượt là \({11.67, -8.33}\) và Giá nhà là $200, 180$ và \(F_0(x) = 188.33\)
$$\begin{align*} y_{21} &= \arg\min_{\gamma} \left[ \frac{1}{2} (200 - (F_{0}(x) + \gamma))^2 +\frac{1}{2} (180 - (F_{0}(x) + \gamma))^2 \right] \\ &\rightarrow y_{21} = \arg\min_{\gamma} \left[ \frac{1}{2} (200 - (188.33 + \gamma))^2 +\frac{1}{2} (180 - (188.33 + \gamma))^2 \right] \\ &\rightarrow y_{21} = \arg\min_{\gamma} \left[ \frac{1}{2} (200 - 188.33 - \gamma)^2 +\frac{1}{2} (180 - 188.33 - \gamma)^2 \right] \\ &\rightarrow y_{21} = \arg\min_{\gamma} \left[ \frac{1}{2} (11.67 - \gamma)^2 +\frac{1}{2} (-8.33 - \gamma)^2 \right] \\ &\rightarrow \frac{\partial}{\partial \gamma} \left[ \frac{1}{2} (11.67 - \gamma)^2 +\frac{1}{2} (-8.33 - \gamma)^2 \right] = 0 \\ &\rightarrow (11.67 - \gamma) + (-8.33 - \gamma) = 0 \\ &\rightarrow 11.67 - 8.33 - 2\gamma = 0 \\ &\rightarrow 3.34 - 2\gamma = 0 \\ &\rightarrow 2\gamma = 3.34 \\ &\rightarrow \gamma = 1.67 \end{align*}$$
Qua việc áp dụng công thức trực tiếp vào bộ dữ liệu có sẵn, ta thấy rằng kết quả đều là trung bình cộng của các giá trị trong một leaf.
Bước 2 - 4
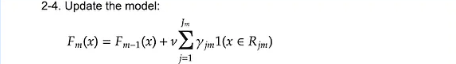
Ở bước cuối cùng, chúng ta cập nhật dự đoán tổng hợp \(F_m\). Mỗi điểm dữ liệu sẽ rơi vào một nút cuối (terminal node) duy nhất, và giá trị \(\gamma\) của nút đó sẽ được cộng vào dự đoán trước đó \(F_{m-1}\) để tạo ra dự đoán mới \(F_m\).
Learning rate quyết định mức độ ảnh hưởng của cây mới vào dự đoán tổng hợp. Chọn giá trị nhỏ giúp giảm nguy cơ overfitting nhưng cũng làm mô hình học chậm hơn.
Để đạt hiệu suất tốt, chúng ta thường lặp lại bước thêm cây này nhiều lần, có thể hơn 100 cây.
Có thể thấy công thức hơi phức tạp, nhưng đó là vì Gradient Boosting được thiết kế linh hoạt với bất kỳ hàm mất mát khả vi nào. Bạn chỉ cần thay hàm mất mát là mô hình vẫn hoạt động. Các thư viện phổ biến như XGBoost hay LightGBM còn cung cấp nhiều lựa chọn hàm mất mát, giúp áp dụng dễ dàng cho nhiều bài toán khác nhau.
3.1.3. Code
Đi đến đây thì chắc hẳn bạn đã hiểu rõ quy trình hoạt động của Gradient Boosting cho bài toán Regression rồi đúng không, giờ tôi sẽ tự code lại phiên bản Gradient Boosting Regressor đơn giản (không dùng sklearn.ensemble.GradientBoostingRegressor) mà chỉ tận dụng DecisionTreeRegressor.
import numpy as np
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error
import matplotlib.pyplot as plt

class GradientBoostingRegressor:
    def __init__(self, n_estimators=100, learning_rate=0.1, max_depth=3,
                 min_samples_split=2, min_samples_leaf=1, random_state=None):
        self.n_estimators = n_estimators
        self.learning_rate = learning_rate
        self.max_depth = max_depth
        self.min_samples_split = min_samples_split
        self.min_samples_leaf = min_samples_leaf
        self.random_state = random_state
        self.train_errors = []
        self.trees = []
        self.initial_prediction = None

    def fit(self, X, y):
        X = np.array(X)
        y = np.array(y)

        # Khởi tạo dự đoán ban đầu
        self.initial_prediction = np.mean(y)
        current_predictions = np.full(len(y), self.initial_prediction)

        for m in range(self.n_estimators):
            residuals = y - current_predictions
            tree = DecisionTreeRegressor(
                max_depth=self.max_depth,
                min_samples_split=self.min_samples_split,
                min_samples_leaf=self.min_samples_leaf,
                random_state=self.random_state
            )
            tree.fit(X, residuals)
            tree_predictions = tree.predict(X)

            # Cập nhật mô hình
            current_predictions += self.learning_rate * tree_predictions
            self.trees.append(tree)
            mse = mean_squared_error(y, current_predictions)
            self.train_errors.append(mse)
        return self

    def predict(self, X):
        X = np.array(X)
        predictions = np.full(X.shape[0], self.initial_prediction)
        for tree in self.trees:
            predictions += self.learning_rate * tree.predict(X)
        return predictions

    # Các hàm trực quan hóa
    def staged_predict(self, X):
        X = np.array(X)
        predictions = np.full(X.shape[0], self.initial_prediction)
        yield predictions.copy()
        for tree in self.trees:
            predictions += self.learning_rate * tree.predict(X)
            yield predictions.copy()

    def plot_boosting_steps(self, X, y, max_steps=6, feature_idx=0):
        # (Code trực quan hóa từng bước boosting – như phần bạn đã có)
        ...

    def plot_learning_curve(self):
        # (Code vẽ Learning Curve)
        ...

    def plot_prediction_evolution(self, X, y, sample_idx=0):
        # (Code theo dõi tiến trình dự đoán của 1 sample)
        ...
Để minh họa, chúng ta sử dụng một hàm demo đơn giản tạo dữ liệu giả lập (80 sample với 2 features), huấn luyện mô hình với 20 estimators, learning rate 0.2, và độ sâu cây 2. Sau đó, tính MSE và R², rồi vẽ các biểu đồ.
def demo_gradient_boosting():
    print("Demo Gradient Boosting Algorithm")
    print("=" * 50)

    np.random.seed(42)
    X = np.random.uniform(0, 10, (80, 2))
    y = 0.5 * X[:, 0]**2 - 2*X[:, 0] + X[:, 1] + np.random.normal(0, 1, 80)

    print(f"Dataset: {X.shape[0]} samples, {X.shape[1]} features")

    print("\nTraining Gradient Boosting...")
    gb = GradientBoostingRegressor(
        n_estimators=20,
        learning_rate=0.2,
        max_depth=2,
        random_state=42
    )
    gb.fit(X, y)

    predictions = gb.predict(X)
    mse = np.mean((y - predictions) ** 2)
    r2 = 1 - (np.sum((y - predictions)**2) / np.sum((y - np.mean(y))**2))

    print(f"\nKết quả:")
    print(f"  Final MSE: {mse:.4f}")
    print(f"  R² Score: {r2:.4f}")
    print("\n Plotting results...")
    gb.plot_boosting_steps(X, y, max_steps=4, feature_idx=0)
    gb.plot_learning_curve()
    gb.plot_prediction_evolution(X, y, sample_idx=0)
    return gb
Mình sẽ nói qua một chút về các hàm mình sử dụng nhé:
fit(): Bắt đầu với dự đoán ban đầu là trung bình của y. Sau đó, lặp qua mỗi estimator: tính residuals, huấn luyện cây trên residuals, cập nhật dự đoán với learning rate, và lưu MSE train.predict(): Dự đoán bằng cách cộng dồn dự đoán từ tất cả cây.staged_predict(): Generator để lấy dự đoán tại từng stage, dùng cho plot evolution.plot_boosting_steps(): Vẽ residuals (bên trái) và predictions (bên phải) cho từng iteration (tối đa max_steps). Bạn sẽ thấy residuals giảm dần, và đường dự đoán \(F_m\) tiến gần dữ liệu thực tế.plot_learning_curve(): Vẽ MSE giảm theo iterations – minh họa boosting cải thiện mô hình dần dần.plot_prediction_evolution(): Theo dõi dự đoán cho một sample cụ thể qua iterations, hội tụ về giá trị thật.
Sau khi chạy, ta sẽ được kết quả như sau:
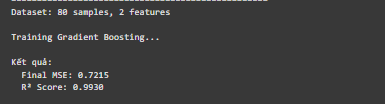
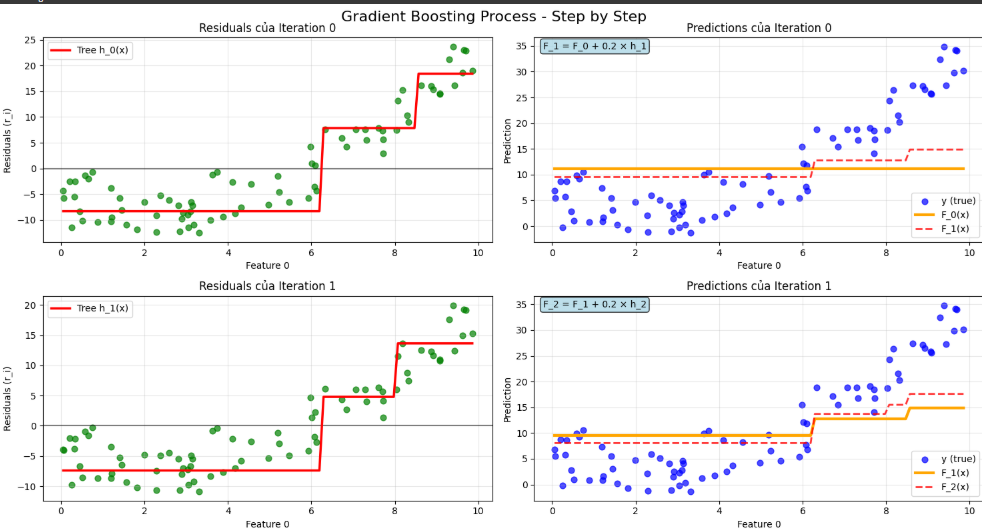
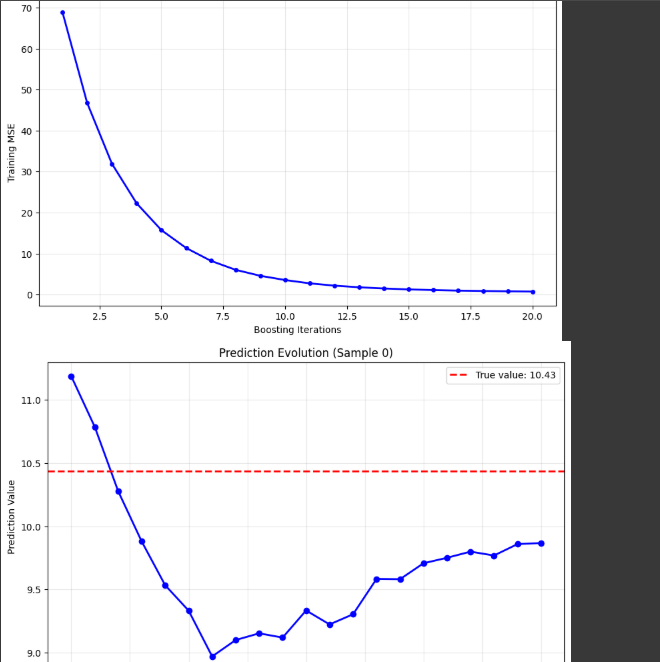
Từ các biểu đồ trên, chúng ta có thể thấy rõ quá trình hoạt động của Gradient Boosting. Ban đầu, mô hình dự đoán chưa chính xác, nhưng qua mỗi lần lặp, thuật toán liên tục học hỏi và sửa chữa lỗi từ các dự đoán trước đó. Điều này được thể hiện qua việc giảm dần các phần dư (residuals) và sự tiến hóa của đường dự đoán, ngày càng tiệm cận với giá trị thực tế.
Nếu muốn xem chi tiết và thử nghiệm, hãy truy cập vào link Colab này: link
Thuật toán mà chúng ta đã đi qua từng bước trên trong phần này chỉ là một trong những lựa chọn của các thuật toán gradient boosting, đặc biệt áp dụng cho các bài toán hồi quy với hàm mất mát bậc hai (squared loss). Tuy nhiên, sức mạnh của gradient boosting không chỉ giới hạn ở hồi quy – nó cũng tỏa sáng trong các bài toán phân loại, nơi các hàm mất mát như log-loss hoặc exponential loss được sử dụng. Trong phần tiếp theo, chúng ta sẽ khám phá cách áp dụng gradient boosting cho các bài toán phân loại, bao gồm cách xử lý nhãn đa lớp và tối ưu hóa mô hình để đạt hiệu suất cao hơn.
3.2. Gradient Boosting trong Classification
Ở phần trên, chúng ta đã cùng tìm hiểu chi tiết về Gradient Boosting trong bài toán Regression. Điểm thú vị là bản chất của thuật toán này không chỉ giới hạn ở regression – nó đủ linh hoạt để áp dụng cho nhiều loại loss function khác nhau, miễn là hàm đó khả vi.
Điều này đồng nghĩa với việc, nếu ta thay hàm mất mát MSE vốn dùng cho regression bằng một hàm phù hợp cho Classification (ví dụ như logistic loss), thì toàn bộ khung thuật toán vẫn giữ nguyên. Tuy nhiên, khi bước sang classification, sẽ có một số khác biệt quan trọng trong cách tính toán và diễn giải.
Trong phần 2 này, chúng ta sẽ cùng khám phá cách Gradient Boosting được triển khai cho Classification, làm rõ những thay đổi cần thiết và xem chúng ảnh hưởng thế nào đến quá trình huấn luyện mô hình.
3.2.1. Ví dụ tính tay với tabular mẫu
Trước khi đi vào chi tiết công thức, hãy hình dung quy trình tổng quát của Gradient Boosting trong classification. Thực ra, ý tưởng cốt lõi vẫn giống như hồi quy: bắt đầu với một mô hình đơn giản, rồi dần dần bù đắp sai số qua từng cây kế tiếp. Nhưng ở đây, thay vì trực tiếp dự đoán một giá trị liên tục (giá nhà chẳng hạn), mô hình sẽ dự đoán xác suất một mẫu thuộc về từng lớp.
Ba bước chính có thể tóm tắt như sau:
Khởi tạo mô hình ban đầu: thường là log-odds từ tỷ lệ mẫu trong mỗi lớp (thay cho việc lấy trung bình như ở regression).
Tính “residuals” mới: không còn đơn thuần là chênh lệch \(y - \hat{y}\), mà là gradient của hàm mất mát phân loại (ví dụ cross-entropy).
Huấn luyện cây kế tiếp: cây mới học từ gradient này để hiệu chỉnh mô hình, sau đó cập nhật xác suất dự đoán cho từng lớp.
Ta vào việc luôn nhé, trước hết ta có dữ liệu sau:
| Drink Coffee | Sleep Hours | Favorite Hobby | Use Social Media |
| Yes | 12 | Blue | Yes |
| Yes | 87 | Green | Yes |
| No | 44 | Blue | No |
| No | 19 | Red | No |
| No | 32 | Green | Yes |
| No | 14 | Blue | Yes |
Ở đây, nhãn cần dự đoán là Yes/No (Use Social Media). Nếu ta thử tính trung bình, sẽ không có ý nghĩa gì, bởi giá trị rời rạc không cộng trừ được như con số liên tục trong regression.
Thay vào đó, Gradient Boosting cho classification thường sử dụng log-odds (logit) làm dự đoán khởi đầu. Nói cách khác:
$$F_0=log \frac{p}{1−p}$$
Trong đó $p$ là xác suất một mẫu thuộc lớp “Yes” trong tập dữ liệu ban đầu. Đây chính là cách mô hình “tóm tắt” thông tin ban đầu về phân bố lớp trước khi bắt đầu học từ gradient/residual.
Tính xác suất lớp “Yes” trong tập dữ liệu:
$$p = \frac{\text{Số mẫu Yes}}{\text{Tổng số mẫu}} = \frac{4}{6} \approx 0.667$$
Dự đoán log-odds ban đầu:
$$F_0 = \log \frac{p}{1-p} = \log \frac{0.667}{0.333} \approx 0.693$$
→ Tức là tất cả các mẫu đều được dự đoán cùng log-odds ban đầu \(F_0 \approx 0.693\).
Trước tiên, chúng ta cần chuyển dự đoán ban đầu \(F_0(x)\) thành xác suất dự đoán \(p_0(x)\). Trong classification, không giống như hồi quy, ta không dự đoán trực tiếp nhãn “Yes/No”, mà dự đoán xác suất một mẫu thuộc về lớp “Yes”. Để làm điều này, Gradient Boosting sử dụng hàm sigmoid:
$$p_0(x) = \frac{1}{1 + e^{-f_0(x)}}$$
Ví dụ, với \(F_0(x) \approx 0.693\), ta có:
$$p_0(x) = \frac{1}{1 + e^{-0.693}} = \frac{1}{1 + 0.5} = \frac{1}{1.5} \approx 0.667$$
Như vậy, xác suất ban đầu là khoảng 0.667 – tương đương với tỷ lệ mẫu “Yes” trong dữ liệu. Đây chính là cách Gradient Boosting “tóm tắt” thông tin ban đầu trước khi học từ gradient.
Tiếp theo, chúng ta cần chuyển nhãn Y sang dạng số, để tính toán gradient: “Yes” được gán giá trị 1, “No” là 0.
Bước quan trọng tiếp theo là tính residuals, hay gradient trong bài toán classification. Với Log-Loss, gradient được xác định bằng sự chênh lệch giữa nhãn thực tế và xác suất dự đoán:
$$r_i = y_i - p_0(x_i)$$
Điều này có nghĩa là cây tiếp theo sẽ không học nhãn trực tiếp nữa, mà học từ sai số giữa dự đoán hiện tại và nhãn thật, để dần dần điều chỉnh xác suất dự đoán của mô hình. Nhờ vậy, mỗi cây mới sẽ “bù đắp” cho phần lỗi còn lại, giúp mô hình ngày càng chính xác hơn.
| Drink Coffee | Sleep Hours | Favorite Hobby | Y (Thực tế) | \(F_0(x)\) | \(p_0(x)\) | Residual |
| Yes | 12 | Blue | 1 | 0.693 | 0.667 | 1−0.667 = 0.333 |
| Yes | 87 | Green | 1 | 0.693 | 0.667 | 1−0.667 = 0.333 |
| No | 44 | Blue | 0 | 0.693 | 0.667 | 0-0.667 = −0.667 |
| No | 19 | Red | 0 | 0.693 | 0.667 | 0−0.667 = −0.667 |
| No | 32 | Green | 1 | 0.693 | 0.667 | 1−0.667 = 0.333 |
| No | 14 | Blue | 1 | 0.693 | 0.667 | 1−0.667 = 0.333 |
Tiếp theo, chúng ta tính residual (sai số) cho mỗi mẫu dựa trên gradient của log-loss:
$$Residual = \frac{\sum \text{Residual}}{\sum(\text{Previous Probability} \times (1 - \text{Previous Probability}))}$$
Sau khi tính residual, chúng ta huấn luyện một cây quyết định (regression tree) trên các giá trị này. (Phần chi tiết cách xây dựng cây sẽ không đi sâu, nhưng nó liên quan đến việc tối ưu hóa giảm gradient của hàm mất mát.)
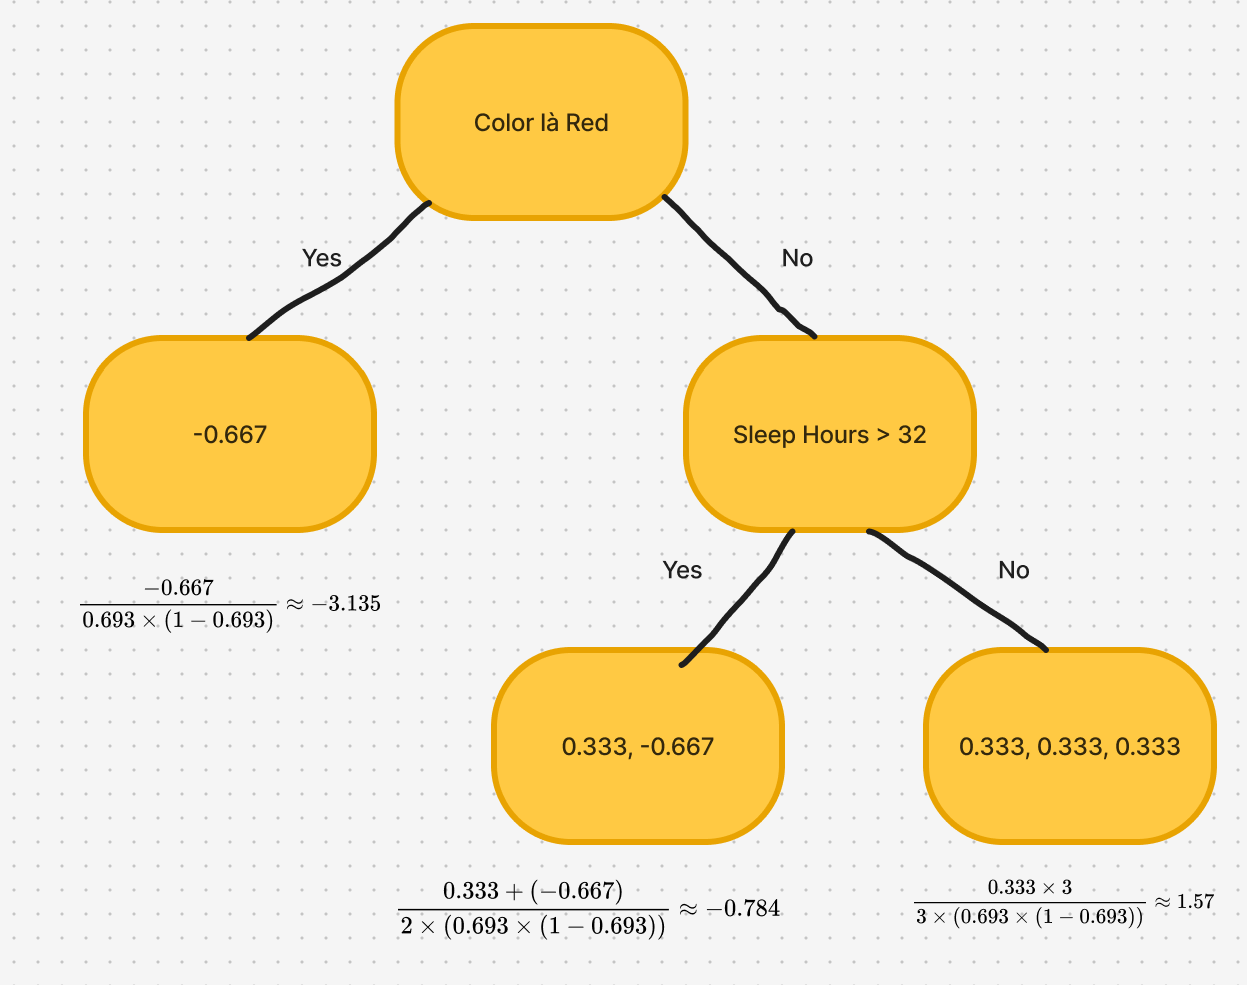
Cập nhật log-odds mới \(F_1(x)\) bằng cách cộng log-odds hiện tại với learning rate \(\alpha\) nhân với giá trị lá từ cây. Giả sử learning rate là 0.1:
Với nhánh "Color = Red": \(F_1 = 0.693 + 0.1 \times \frac{-0.667}{0.693 \times (1 - 0.693)} \approx 0.380\)
Với nhánh "Sleep Hours > 32" dẫn đến 0.333 và (-0.667): \(F_1 = 0.693 + 0.1 \times \frac{0.333 + (-0.667)}{0.693 \times (1 - 0.693) + 0.693 \times (1 - 0.693)} \approx 0.693 + 0.1 \times -0.784 \approx 0.614\)
Với nhánh "Sleep Hours <= 32" dẫn đến 0.333, 0.333, 0.333:\(F_1 = 0.693 + 0.1 \times \frac{0.333 + 0.333 + 0.333}{0.212751} \approx 0.693 + 0.1 \times 1.57 \approx 0.850\)
Cuối cùng, để lấy xác suất, ta áp dụng hàm sigmoid trên \(F_1(x)\):
Với nhánh "Color = Red": \(p = \frac {1}{1+e^{-0.380}} \approx 0.593\)
Với nhánh "Sleep Hours > 32" dẫn đến 0.333 và (-0.667): \(p = \frac {1}{1+e^{-0.614}} \approx 0.648\)
Với nhánh "Sleep Hours <= 32" dẫn đến 0.333, 0.333, 0.333: \(p = \frac {1}{1+e^{-0.850}} \approx 0.7\)
Quá trình này cho thấy cách Gradient Boosting tinh chỉnh log-odds theo hướng giảm gradient của hàm mất mát log-loss, qua đó cải thiện khả năng phân loại qua từng iteration.
| Drink Coffee | Sleep Hours | Favorite Hobby | Y | \(F_0(x)\) | \(p_0(x)\) | Residual \(r_0\) | \(F_1(x)\) | \(p_1(x) = \frac {1}{1+e^{-F_1(x)}}\) | Residual \(r_1 = Y - p_1(x)\) |
| Yes | 12 | Blue | 1 | 0.693 | 0.667 | 0.333 | 0.850 | 0.7 | 0.3 |
| Yes | 87 | Green | 1 | 0.693 | 0.667 | 0.333 | 0.614 | 0.648 | 0.352 |
| No | 44 | Blue | 0 | 0.693 | 0.667 | −0.667 | 0.614 | 0.648 | -0.648 |
| No | 19 | Red | 0 | 0.693 | 0.667 | −0.667 | 0.380 | 0.593 | -0.593 |
| No | 32 | Green | 1 | 0.693 | 0.667 | 0.333 | 0.850 | 0.7 | 0.3 |
| No | 14 | Blue | 1 | 0.693 | 0.667 | 0.333 | 0.850 | 0.7 | 0.3 |
Qua từng bước, chúng ta sẽ lặp lại việc huấn luyện cây mới trên \(r_1\), cập nhật \(F_2(x)\), và tiếp tục cho đến khi mô hình hội tụ hoặc đạt số lượng cây mong muốn, từ đó tinh chỉnh dự đoán một cách chính xác hơn.
3.2.2. Ý nghĩa toán học đằng sau
Giờ mình sẽ chuyển sang phân tích toán học chi tiết đằng sau thuật toán này để bạn hiểu rõ hơn về cơ sở lý thuyết. Dựa trên các bước đã trình bày trước đó, chúng ta sẽ giải thích kỹ lưỡng từng phần, tập trung vào các khía cạnh toán học.
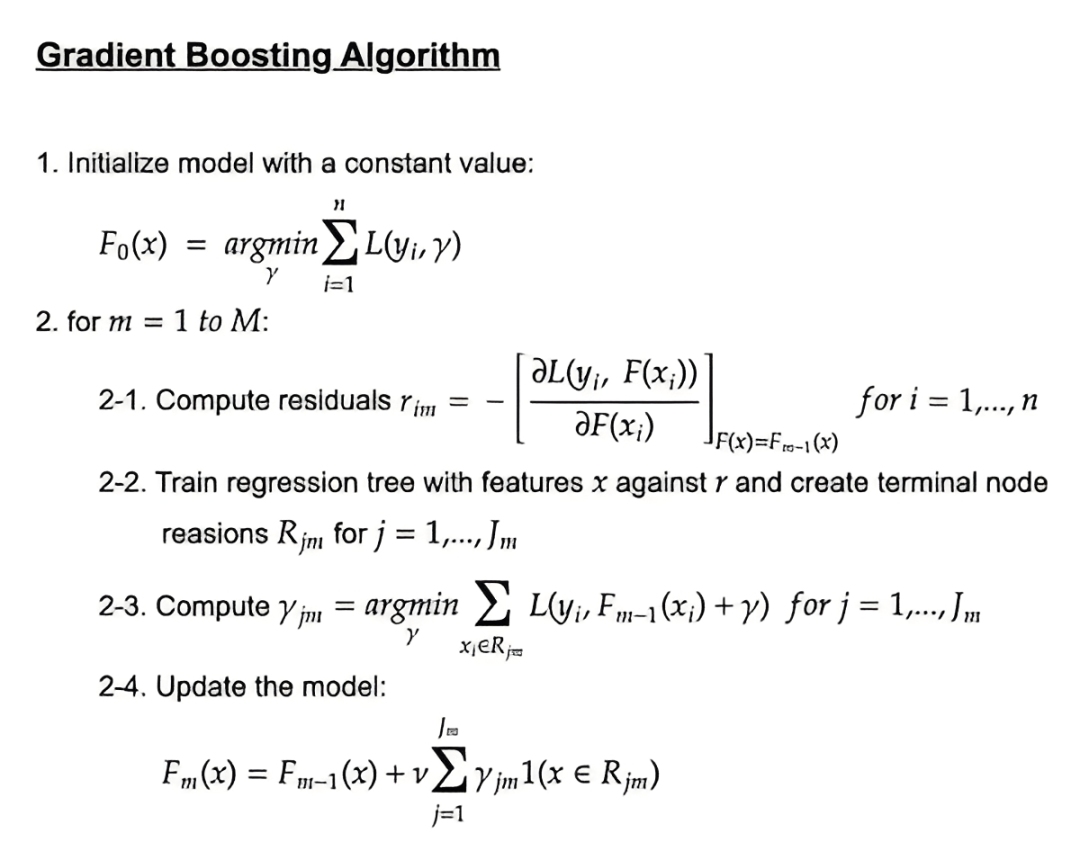
Cũng giống như bài toán Regression, ta vẫn áp dụng các bước tương tự lên cho bài toán Classification:
Bước 1 - 1
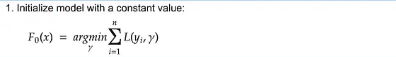
Trong hồi quy logistic, thay vì làm việc trực tiếp với xác suất $p$ (giá trị từ 0 đến 1), chúng ta sử dụng log-odds, được định nghĩa là:
$$log(odds) = log(\frac{p}{1-p})$$
Ở đây, \(\frac {p}{1-p}\) là tỷ lệ cược (odds), biểu thị khả năng xảy ra sự kiện so với không xảy ra. Log-odds là phép biến đổi logarit tự nhiên của tỷ lệ cược này, giúp ánh xạ xác suất từ khoảng (0, 1) sang một không gian tuyến tính, phù hợp để áp dụng các phương pháp tối ưu hóa tuyến tính.
Hàm dự đoán ban đầu \(F_0(x)\) được định nghĩa là:
$$F_0(x) = \log\!\left(\frac{\bar{y}}{1 - \bar{y}}\right)$$
Để chứng minh, ta cần tìm một giá trị gamma tối ưu để khởi tạo mô hình. Trong Boosting, bước đầu tiên là tìm một hằng số gamma đơn lẻ (còn gọi là \(F_0\)) để giảm thiểu hàm mất mát. Đối với bài toán phân loại nhị phân sử dụng hàm mất mát Log-loss, giá trị gamma tối ưu này chính là log-odds của xác suất trung bình của lớp dương trong tập huấn luyện.
Giả sử chúng ta có một tập dữ liệu huấn luyện với N mẫu, và \(y_i\) là nhãn thực tế cho mẫu thứ i (trong đó \(y_i\) = 1 cho lớp dương và \(y_i\) = 0 cho lớp âm).
Hàm mất mát Log-loss (hay còn gọi là Binary Cross-Entropy) cho một dự đoán F(x) là:
$$L(y, F(x)) = y \cdot \log\big(p(x)\big) + (1 - y) \cdot \log\big(1 - p(x)\big)$$
Ở đây, $p(x)$ là xác suất dự đoán của \(y=1\), và $p(x)$ có thể được tính từ $F(x)$ thông qua hàm sigmoid:
$$\begin{align*} \log\left(\frac{p}{1-p}\right) &= \log(\text{odds}) \\ \Rightarrow \quad \frac{p}{1-p} &= e^{\log(\text{odds})} \\ \Rightarrow \quad p &= (1 - p) e^{\log(\text{odds})} \\ \Rightarrow \quad p &= e^{\log(\text{odds})} - p \, e^{\log(\text{odds})} \\ \Rightarrow \quad p + p \, e^{\log(\text{odds})} &= e^{\log(\text{odds})} \\ \Rightarrow \quad p (1 + e^{\log(\text{odds})}) &= e^{\log(\text{odds})} \\ \Rightarrow \quad p &= \frac{e^{\log(\text{odds})}}{1 + e^{\log(\text{odds})}} \end{align*}$$
Bước đầu tiên trong Gradient Boosting là tìm một hằng số (\(F_0(x)\) = \(\gamma\) cho tất cả các x) để giảm thiểu tổng hàm mất mát trên toàn bộ tập dữ liệu:
$$\gamma^{*} = \arg\min_{\gamma} \left[ \sum_{i=1}^{N} L(y_i, \gamma) \right]$$
Để tìm \(\gamma^{*}\), chúng ta lấy đạo hàm của hàm mất mát theo \(\gamma\) và đặt bằng 0. Khi làm điều này với hàm mất mát Log-loss, chúng ta sẽ thấy rằng \(\gamma^{*}\) chính là log-odds của tỷ lệ các mẫu lớp dương trong tập huấn luyện.
Tỷ lệ các mẫu lớp dương (tức là xác suất trung bình của y = 1) được ký hiệu là \(\bar{y} \) :
$$\bar{y} = \frac{\sum_{i=1}^{N} y_i}{N}$$
Vậy nên, hàm dự đoán ban đầu \(F_0(x)\) được định nghĩa là log-odds của \(\bar{y} \) :
$$F_0(x) = \log\!\left(\frac{\bar{y}}{1 - \bar{y}}\right)$$
Ta có thể lấy ví dụ trên làm thử nhé:
| Drink Coffee | Sleep Hours | Favorite Color | Use Social Media |
| Yes | 12 | Blue | Yes |
| No | 87 | Green | Yes |
| No | 44 | Blue | No |
Đầu tiên, ta xét hàm mất mát log-loss cho một mẫu dữ liệu trong bài toán phân loại nhị phân. Hàm này được viết lại theo log-odds như sau:
$$L(y, \hat{y}) = (\text{Observed} \cdot \log(\text{odds})) - \text{Observed} \cdot \log(\text{odds}) + \log\!\big(1 + e^{\text{odds}}\big)$$
Tiếp theo, ta tìm giá trị của hàm dự đoán $F_\theta(x)$ bằng cách cực tiểu hóa tổng log-loss trên toàn bộ dữ liệu:
$$F_\theta(\mathbf{x}) = \arg\min_{\hat{y} = -1}^{1} \sum \Big( - \text{Observed} \cdot \log(\text{odds}) + \log\!\big(1 + e^{\text{odds}}\big) \Big)$$
Trong ví dụ này, ta thay các giá trị vào công thức để tính toán cụ thể. Khi đó ta có:
$$\begin{align*} \hat{y} &= -1 + p(-1 + p) + (0 \cdot p) + 0 \\ &= \tfrac{2}{3}, \quad \log(\text{odds}) = \log\!\left(\tfrac{p}{1 - p}\right) = \log\!\left(\tfrac{2}{1}\right) \\ &= F_\theta(\mathbf{x}) = \log(2) - 0.69 \end{align*}$$
Bước 2 - 1
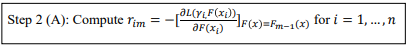
Tiếp theo, chúng ta sẽ sử dụng mối quan hệ này để biến đổi hàm mất mát và áp dụng các phương pháp tối ưu hóa tuyến tính, như đã đề cập.
$$L = -\sum_{i=1}^n \left[ y_i \cdot \log(p_i) + (1 - y_i) \cdot \log(1 - p_i) \right]$$
\(y_i\): Giá trị nhãn thực tế (0 hoặc 1).
\(p_i\): Xác suất dự đoán cho mẫu thứ i i i.
$n$: Số lượng mẫu trong tập dữ liệu.
Hàm này đo lường sự khác biệt giữa nhãn thực tế \(y_i\) và xác suất dự đoán \(p_i\). Khi \(y_i=1\), thành phần \(-y_i \times log(p_i)\) chiếm ưu thế, và khi \(y_i=0\), thành phần \(-(1-y_i) \times log(1-p_i)\) trở nên quan trọng. Mục tiêu là tối thiểu hóa $L$ để cải thiện độ chính xác của mô hình, nên ta có dấu trừ ở đằng trước vì thực chất, nếu ta có prediction càng nhiều thì hàm log cảng lớn.
Dưới đây là phần giải thích cách tính \(log(1-p)\) dựa trên Log-odds:
$$\log(1 - p) = \log\left(\frac{e^{\log(\text{odds})}}{1 + e^{\log(\text{odds})}}\right) = \log\left(\frac{1 + e^{\log(\text{odds})}}{1 + e^{\log(\text{odds})}} \cdot \frac{e^{\log(\text{odds})}}{1 + e^{\log(\text{odds})}}\right) = \log\left(\frac{1}{1 + e^{\log(\text{odds})}}\right) = \log(1 - (1 + e^{\log(\text{odds})}))$$
Sau đó, ta áp dụng Logit vào dữ liệu thực tế(Observed):
$$\begin{align} (-1)\Big[ y_i \cdot \log(p) + (1 - y_i) \cdot \log(1 - p) \Big] &\Rightarrow (-1)\Big[ \text{Observed} \cdot \log(p) + (1 - \text{Observed}) \cdot \log(1 - p) \Big] \\[6pt] &\Rightarrow -\text{Observed} \cdot \log(p) - (1 - \text{Observed}) \cdot \log(1 - p) \\[6pt] &\Rightarrow -\text{Observed} \cdot \log(p) + \log(1 - p) + \text{Observed} \cdot \log(1 - p) \\[6pt] &\Rightarrow -\text{Observed} \cdot \log(p) - \log(1 - p) \\[6pt] &\Rightarrow -\text{Observed} \cdot \log(\text{odds}) - \log(1 - p) \\[6pt] &\Rightarrow -\text{Observed} \cdot \log(\text{odds}) + \log\!\big(1 + e^{\log(\text{odds})}\big) \end{align}$$
Thay \(p = \frac {e ^ {log(odds)}}{1 + e ^ {log(odds)} }\) vào, ta có:
$$\begin{align} \frac{d}{d \log(\text{odds})} \Big[ - \text{Observed} \cdot \log(\text{odds}) + \log\!\big(1 + e^{\log(\text{odds})}\big) \Big] &\Rightarrow -\text{Observed} + \frac{1}{1 + e^{\log(\text{odds})}} \cdot e^{\log(\text{odds})} \\[6pt] &\Rightarrow -\text{Observed} + \frac{e^{\log(\text{odds})}}{1 + e^{\log(\text{odds})}} \\[6pt] &= -\text{Observed} + p \end{align}$$
Từ đây, ta thấy đạo hàm của hàm mất mát theo log(odds) chính là (p – Observed), tức là sai khác giữa giá trị dự đoán và giá trị quan sát. Đây chính là nền tảng để ta cập nhật mô hình ở các bước tiếp theo.
Bước 2 - 2
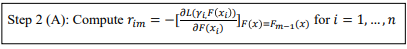
Ở bước này, ta có thể hiểu nó tương tự như phần regression bên trên.
Bước 2 - 3
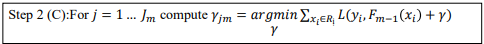
Bước tiếp theo, ta tìm hiểu quy trình tối ưu hóa một mô hình học máy bằng cách xác định giá trị tối ưu của \(\gamma _ {jm}\) cho mỗi nút cuối cùng $j$. Mục tiêu của chúng ta là giảm thiểu hàm mất mát trên các nút này. Thuật ngữ \(\sum_{x_i \in R_{jm}} L\) đại diện cho tổng mất mát được tổng hợp từ tất cả các điểm dữ liệu \(x_i\) thuộc về nút cuối cùng \(R_{jm}\). Để tiếp tục, chúng ta sẽ thay hàm mất mát vào phương trình này.
$$\gamma_{jm} = \arg\min_{\gamma} \sum_{x_i \in R_{jm}} L\big(y_i, F_{m-1}(x_i) + \gamma\big) = \arg\min_{\gamma} \sum_{x_i \in R_{jm}} \Big[ -\big( y_i \cdot (F_{m-1}(x_i) + \gamma) - \log\big(1 + e^{F_{m-1}(x_i) + \gamma}\big) \big) \Big]$$
Việc xác định giá trị của \(\gamma _{jm}\) từ phương trình này là một thứ khá khoai đó. Để đơn giản hóa quá trình giải, chúng ta sẽ xấp xỉ hàm mất mát $L$ bằng đa thức Taylor bậc hai. Phương pháp này cho phép biểu diễn bất kỳ hàm số nào dưới dạng một đa thức với số hạng hữu hạn hoặc vô hạn:
$$L(y, F_{m-1}(x_i) + \gamma) \approx L(y, F_{m-1}(x_i)) + \frac{\partial L(y, F_{m-1}(x_i))}{\partial F} \gamma + \frac{1}{2} \frac{\partial^2 L(y, F_{m-1}(x_i))}{\partial F^2} \gamma^2$$
Chúng ta sẽ thay thế xấp xỉ này của $L$ vào phương trình của γjm \(\gamma _ {jm}\), sau đó tìm giá trị của \(\gamma _ {jm}\) sao cho đạo hàm của \(\sum(*)\) bằng không.
$$\begin{align*} \frac{\partial}{\partial \gamma} \sum_{x_i \in R_{jm}} & L\big(y_i, F_{m-1}(x_i) + \gamma\big) \\[1mm] &= \sum_{x_i \in R_{jm}} \frac{\partial}{\partial F} L\big(y_i, F_{m-1}(x_i)\big) \, \gamma + \frac{1}{2} \sum_{x_i \in R_{jm}} \frac{\partial^2}{\partial F^2} L\big(y_i, F_{m-1}(x_i)\big) \, \gamma^2 = 0 \\[2mm] \text{Đặt } g_i &= \frac{\partial}{\partial F} L\big(y_i, F_{m-1}(x_i)\big), \quad h_i = \frac{\partial^2}{\partial F^2} L\big(y_i, F_{m-1}(x_i)\big) \\[1mm] \sum_{x_i \in R_{jm}} \big( g_i \gamma + \tfrac{1}{2} h_i \gamma^2 \big) &= 0 \\[1mm] \sum_{x_i \in R_{jm}} h_i \, \gamma - \sum_{x_i \in R_{jm}} g_i &= 0 \\[1mm] \gamma &= \frac{\sum_{x_i \in R_{jm}} g_i}{\sum_{x_i \in R_{jm}} h_i} \end{align*}$$
Ta có:
$$\frac{\partial L(y_i, F(x_i))}{\partial F(x_i)} = -(y_i - p)$$
Thay vào ta được:
$$\begin{align*} \gamma &= \frac{\sum_{x_i \in R_{jm}} -(y_i - p)}{\sum_{x_i \in R_{jm}} \frac{\partial^2 L}{\partial F^2}} \\[1mm] &= \frac{\sum_{x_i \in R_{jm}} (p - y_i)}{\sum_{x_i \in R_{jm}} \frac{\partial^2 L}{\partial F^2}} \\[1mm] &= -\frac{\sum_{x_i \in R_{jm}} (y_i - p)}{\sum_{x_i \in R_{jm}} \frac{\partial^2 L}{\partial F^2}} \quad \text{(Derivative of } y \text{ is zero)} \\[1mm] &= -\frac{\sum_{x_i \in R_{jm}} (y_i - p)}{\sum_{x_i \in R_{jm}} [p(1 - p)]} \\[1mm] &= -\frac{\sum_{x_i \in R_{jm}} \big[ p(1-p) \cdot \frac{(y_i - p)}{p(1-p)} \big]}{\sum_{x_i \in R_{jm}} p(1-p)} \quad \text{(Apply product rule)} \\[1mm] &= -\frac{\sum_{x_i \in R_{jm}} (y_i - p)}{\sum_{x_i \in R_{jm}} [p(1-p)]} \\[1mm] &= -\frac{\sum (y_i - p)}{\sum (p - p^2)} \\[1mm] \sum (p - p^2) &= \sum p - \sum p^2, \quad \sum (y_i - p) = \sum y_i - \sum p, \quad \sum_{x_i \in R_{jm}} (p - p^2) = \sum_{x_i \in R_{jm}} p(1 - p) \end{align*}$$
Sau khi thay thế và đơn giản hóa, giá trị \(\gamma\) được biểu diễn dưới dạng một tỉ lệ giữa tổng các sai số \(y_i - p\) và tổng các giá trị liên quan đến phương sai của xác suất \(p \times (p-1)\) trên tất cả các điểm dữ liệu trong nút cuối \(R_{jm}\). Kết quả cuối cùng cho thấy \(\gamma\) được tính bằng cách lấy giá trị trung bình gia quyền của các sai số, phản ánh sự điều chỉnh tối ưu cho mô hình tại nút này.
Bước 2 - 4
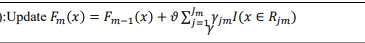
Để kết thúc bước này, mô hình được cập nhật bằng cách cộng các giá trị \(\gamma _ {jm}\)vào dự đoán trước đó \(F_{m-1}(x)\) tại mỗi nút lá \(R_{jm}\). Các giá trị \(\gamma _ {jm}\) được tính toán nhằm tối ưu hóa hàm mất mát, nhờ đó mô hình mới \(F_m(x)\) phản ánh các điều chỉnh tốt hơn dựa trên dữ liệu tại các nút cuối.
Ta thấy được rằng ở bài toán phân loại (classification), việc giải thích toán học phức tạp hơn so với hồi quy (regression). Nguyên nhân là do sự hiện diện của các hàm mất mát phi tuyến như log-loss, cùng với sự phụ thuộc vào xác suất. Điều này đòi hỏi phải sử dụng các kỹ thuật xấp xỉ và tính đạo hàm bậc cao để xử lý hiệu quả.
3.2.3. Code
Ở phần trên chúng ta đã xây dựng Gradient Boosting cho Regression. Bây giờ, ta sẽ làm điều tương tự cho bài toán Classification nhị phân (0/1). Thay vì tối ưu MSE như ở regression, ở đây ta sử dụng log-loss và bắt đầu với dự đoán ban đầu \(F_0 = \log \frac{p}{1-p}\), trong đó $p$ là tỉ lệ nhãn dương trong dữ liệu.
Sau đó, mỗi vòng boosting ta sẽ:
Tính xác suất dự đoán hiện tại qua hàm sigmoid.
Tính residual = \(y - p\)
Train một cây regression nhỏ (DecisionTreeRegressor) để xấp xỉ residual.
Với từng lá, tính \(\gamma\) rồi cập nhật \(F_m\)
Cập nhật accuracy và log-loss để theo dõi tiến trình huấn luyện.
class GradientBoostingClassifier:
    def __init__(self, learning_rate=0.1, n_estimators=100, max_depth=1):
        self.learning_rate = learning_rate
        self.n_estimators = n_estimators
        self.max_depth = max_depth
        self.F_0 = None
        self.trees = []
        self.train_scores_ = []
        self.val_scores_ = []
        self.train_losses_ = []
        self.val_losses_ = []

    def log_odds(self, p):
        return np.log(p / (1 - p))

    def sigmoid(self, x):
        return 1 / (1 + np.exp(-x))

    def fit(self, X, y, X_val=None, y_val=None):
        X = np.array(X)
        y = np.array(y)
        if set(np.unique(y)) != {0, 1}:
            raise ValueError("y must be binary {0,1}")

        if X_val is None or y_val is None:
            X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=42)
        else:
            X_train, y_train = X, y
            X_val, y_val = np.array(X_val), np.array(y_val)

        p = np.mean(y_train)
        self.F_0 = self.log_odds(p)
        F_m = np.full(y_train.shape, self.F_0)

        self.train_scores_ = []
        self.val_scores_ = []
        self.train_losses_ = []
        self.val_losses_ = []

        for m in range(self.n_estimators):
            prob = self.sigmoid(F_m)
            residual = y_train - prob
            tree = DecisionTreeRegressor(max_depth=self.max_depth, random_state=0)
            tree.fit(X_train, residual)
            ids = tree.apply(X_train)
            for leaf_id in np.unique(ids):
                mask = ids == leaf_id
                numerator = residual[mask].sum()
                denominator = (prob[mask] * (1 - prob[mask])).sum()
                if denominator == 0:
                    gamma = 0
                else:
                    gamma = numerator / denominator
                F_m[mask] += self.learning_rate * gamma
                tree.tree_.value[leaf_id, 0, 0] = gamma
            self.trees.append(tree)

            train_pred = self.predict_proba_partial(X_train, m+1)
            val_pred = self.predict_proba_partial(X_val, m+1)

            train_acc = accuracy_score(y_train, (train_pred >= 0.5).astype(int))
            val_acc = accuracy_score(y_val, (val_pred >= 0.5).astype(int))

            train_loss = log_loss(y_train, train_pred)
            val_loss = log_loss(y_val, val_pred)

            self.train_scores_.append(train_acc)
            self.val_scores_.append(val_acc)
            self.train_losses_.append(train_loss)
            self.val_losses_.append(val_loss)

        return self

    def predict_proba_partial(self, X, n_trees=None):
        if n_trees is None:
            n_trees = len(self.trees)

        X = np.array(X)
        F_m = np.full(X.shape[0], self.F_0)
        for i in range(min(n_trees, len(self.trees))):
            F_m += self.learning_rate * self.trees[i].predict(X)
        return self.sigmoid(F_m)

    def predict_proba(self, X):
        return self.predict_proba_partial(X, len(self.trees))

    def predict(self, X, threshold=0.5):
        return (self.predict_proba(X) >= threshold).astype(int)

    def plot_boosting_steps(self, X, y, max_steps=6, feature_idx=0):
        # (Code trực quan hóa từng bước boosting – như phần bạn đã có)
        ...

    def plot_learning_curve(self):
        # (Code vẽ Learning Curve)
        ...

    def plot_prediction_evolution(self, X, y, sample_idx=0):
        # (Code theo dõi tiến trình dự đoán của 1 sample)
        ...
Tương tự như regression, ta viết hàm demo_gradient_boosting() để thử nghiệm:
def demo_gradient_boosting():
    print("Demo Gradient Boosting Algorithm")
    print("=" * 50)

    np.random.seed(42)
    X = np.random.uniform(0, 10, (80, 2))
    y = 0.5 * X[:, 0]**2 - 2*X[:, 0] + X[:, 1] + np.random.normal(0, 1, 80)
    y = (y > np.median(y)).astype(int)

    print(f"Dataset: {X.shape[0]} samples, {X.shape[1]} features")
    print("\nTraining Gradient Boosting...")

    gb = GradientBoostingClassifier(
        n_estimators=20,
        learning_rate=0.2,
        max_depth=2
    )
    gb.fit(X, y)

    predictions = gb.predict(X)
    prob_predictions = gb.predict_proba(X)
    acc = accuracy_score(y, predictions)

    print(f"\nKết quả:")
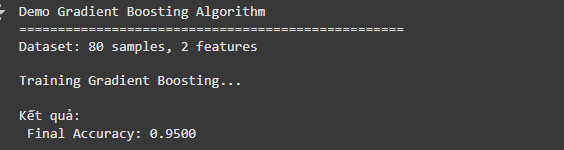
    print(f" Final Accuracy: {acc:.4f}")

    print("\nPlotting results...")
    gb.plot_boosting_steps(X, y, max_steps=4, feature_idx=0)
    gb.plot_learning_curve()
    gb.plot_prediction_evolution(X, y, sample_idx=0)

    return gb
Về cơ bản, việc ta triển khai code cũng khá giống với logic của phần Gradient Boosting cho Regression, mình sẽ nói qua một số hàm quan trọng và khác biệt nhé:
__init__: khởi tạo các tham số cơ bản nhưlearning_rate,n_estimators,max_depth, và các list để theo dõi quá trình train/validation (accuracy, loss).log_odds&sigmoid: các hàm tiện ích để chuyển đổi qua lại giữa logit và xác suất.fit: ở hàm này sẽ khác so với phần regression nhé. Đầu tiên mô hình khởi tạo log-odds ban đầu \(F_0\) Ở mỗi vòng lặp, ta tính xác suất \(p = \sigma \times F_m\), residual \(r = y - p\), huấn luyện một cây hồi quy trên residual, rồi dùngapply()để xác định lá mà mỗi mẫu rơi vào. Từ đó, ta tính gamma cho từng lá \(\gamma = \frac {\sum r}{\sum p \times (1-p)}\) và cập nhật giá trị dự đoán \(F_m\). Sau mỗi vòng, mô hình lưu lại train/val accuracy và log-loss để theo dõi.predict_proba_partial&predict_proba: tính xác suất dự đoán bằng cách cộng logit từ các cây (có nhânlearning_rate) rồi đưa qua sigmoid.predict: phân loại nhị phân bằng cách so sánh xác suất với ngưỡng (thường là 0.5).Các hàm trực quan hóa (
plot_boosting_steps,plot_learning_curve,plot_prediction_evolution) sẽ giúp ta họa mô hình học thêm được gì ở từng vòng boosting, diễn biến train/val loss, và quá trình cập nhật dự đoán của một sample.
Sau khi chạy, bạn sẽ thấy được kết quả như sau:
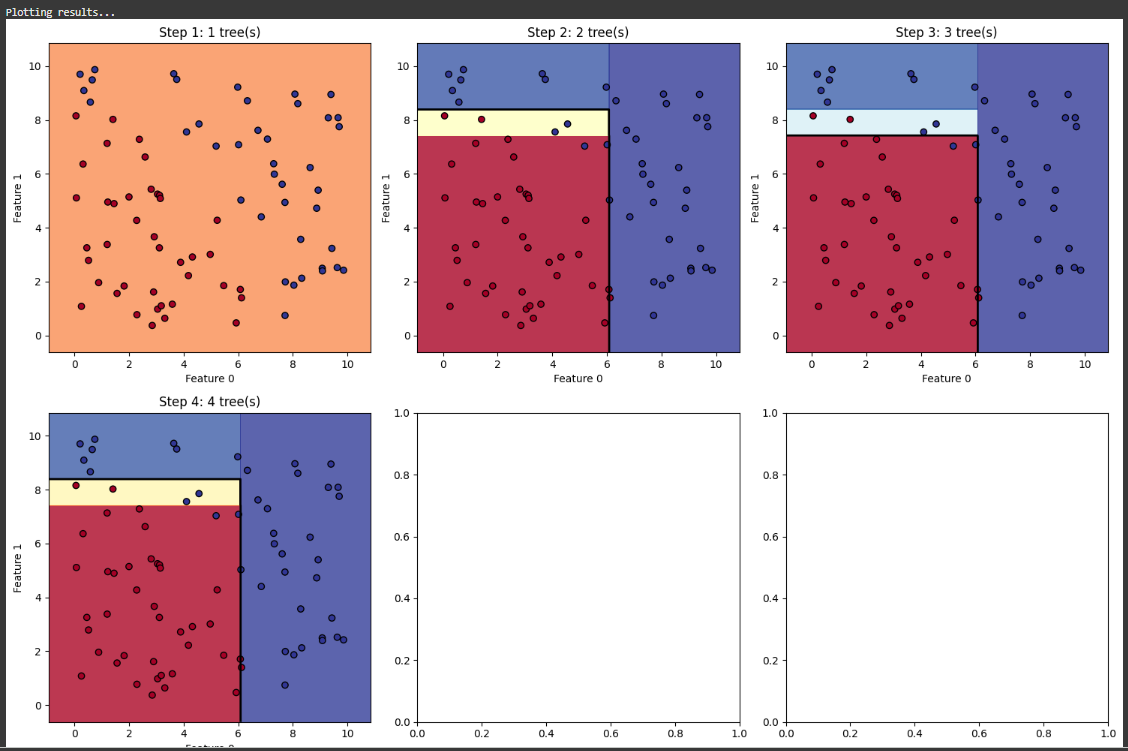
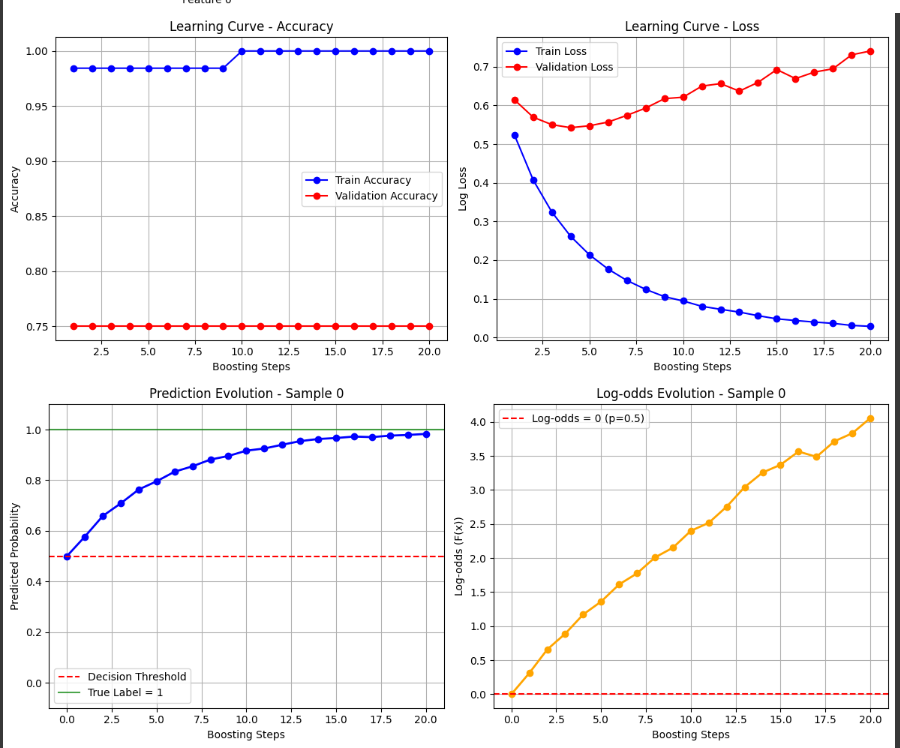
Sau khi chạy demo, bạn sẽ thấy kết quả trực quan như trên: một biểu đồ từng bước boosting, learning curve, và sự tiến hóa dự đoán của một sample. Những biểu đồ này giúp bạn hiểu rõ cách Gradient Boosting cập nhật dự đoán qua từng cây, cũng như hiệu quả tổng thể của mô hình.
Qua ví dụ này, bạn có thể thấy rằng Gradient Boosting không chỉ mạnh mẽ với bài toán regression mà còn dễ dàng áp dụng cho classification, chỉ cần chuyển residual thành gradient của log-loss.
Nếu bạn muốn xem chi tiết code và thử nghiệm trực tiếp, mình đã chuẩn bị notebook Colab đầy đủ để bạn có thể chạy và tùy chỉnh các tham số: link
4. Những cải tiến của XGBoost so với Gradient Boosting
Vì blog này đã đi sâu vào Gradient Boosting (GB) truyền thống, chúng ta hãy dành chút thời gian để nói qua về XGBoost – một phiên bản nâng cao và phổ biến nhất của GB. Điều này sẽ giúp chuẩn bị cho một bài blog chi tiết hơn về XGBoost sau này. XGBoost không chỉ kế thừa tinh hoa của GB mà còn cải tiến đáng kể ở nhiều khía cạnh, giúp nó hiệu quả hơn, nhanh hơn và linh hoạt hơn với dữ liệu thực tế. Dưới đây là các lý do chính khiến XGBoost vượt trội so với GB truyền thống, với các so sánh tương tự như trong Gradient Descent (GD) để dễ hình dung.
Regularization (Điều Chuẩn Hóa) GB truyền thống thường chỉ dựa vào shrinkage (learning rate) và subsampling để tránh overfitting, nhưng điều này đôi khi chưa đủ mạnh mẽ. XGBoost bổ sung trực tiếp L1 (Lasso) và L2 (Ridge) regularization vào hàm mục tiêu, giúp kiểm soát độ phức tạp của cây (như giới hạn số lượng lá hoặc độ sâu), từ đó tránh overfitting hiệu quả hơn. ⇒ Tương tự như trong GD, nơi weight decay được thêm vào để mô hình tổng quát hóa tốt hơn, tránh các trọng số quá lớn.
Parallelization (Song Song Hóa) GB truyền thống xây dựng cây theo cách tuần tự, dẫn đến việc chọn split (điểm phân nhánh) khá chậm, đặc biệt với dữ liệu lớn. XGBoost sử dụng cấu trúc block cho dữ liệu, cho phép tính histogram và tìm split song song theo từng cột, tận dụng tối đa CPU đa lõi. ⇒ Kết quả là huấn luyện nhanh hơn gấp nhiều lần. Điều này giống như việc chuyển từ GD chuẩn (xử lý toàn bộ dữ liệu tuần tự) sang mini-batch GD (xử lý song song các batch nhỏ).
Sparse-Aware (Xử Lý Dữ Liệu Thưa) GB truyền thống thường yêu cầu xử lý trước các giá trị missing/null (như impute bằng trung bình hoặc median), có thể làm méo mó dữ liệu. XGBoost tự động học cách xử lý giá trị missing bằng cách chọn hướng phân nhánh mặc định (default direction) tối ưu cho chúng. ⇒ Rất hữu ích với dữ liệu thực tế thường thưa thớt hoặc có missing values, giúp mô hình robust hơn mà không cần preprocessing phức tạp.
Weighted Quantile Sketch XGBoost sử dụng thuật toán sketch đặc biệt để chọn split tối ưu, đặc biệt với dữ liệu có trọng số (weights). Điều này giúp xử lý tốt hơn các trường hợp dữ liệu mất cân bằng (class imbalance), như trong phân loại. ⇒ Trong khi GB truyền thống không tối ưu hóa tốt cho dữ liệu có trọng số, XGBoost làm cho quá trình chọn split chính xác và hiệu quả hơn, giống như một phiên bản nâng cao của histogram approximation.
System Optimizations (Tối Ưu Hóa Hệ Thống) XGBoost có nhiều cải tiến hệ thống như out-of-core computation (xử lý dữ liệu lớn hơn RAM bằng disk caching), cache-aware design (tối ưu truy cập memory để giảm thời gian chờ), và kết hợp shrinkage với column sampling (tương tự Random Forest để tăng tính đa dạng). ⇒ Những tính năng này làm cho XGBoost phù hợp với dữ liệu lớn, trong khi GB truyền thống dễ gặp bottleneck về tài nguyên.
Tối Ưu Hóa Hàm Mục Tiêu (Second-Order Approximation) GB truyền thống chỉ sử dụng gradient bậc 1 (first-order) để chọn split, dẫn đến ước lượng chưa chính xác tối đa. XGBoost tận dụng cả gradient (first-order) và Hessian (second-order derivative) để xấp xỉ hàm mất mát, giúp tìm split nhanh và chính xác hơn. ⇒ Tương tự như việc chuyển từ GD thông thường (chỉ dùng gradient) sang Newton's method (sử dụng cả Hessian), giúp hội tụ nhanh hơn và ổn định hơn.
Tóm lại, XGBoost không chỉ là một "nâng cấp" của GB mà còn là một hệ thống được thiết kế lại để đối phó với các thách thức thực tế như dữ liệu lớn, thưa thớt và mất cân bằng. Những cải tiến này làm cho XGBoost trở thành lựa chọn hàng đầu trong các cuộc thi Kaggle và ứng dụng sản xuất. Trong blog tiếp theo, chúng ta sẽ đi sâu hơn vào cách triển khai và các tham số quan trọng của XGBoost!
5. Kết luận
Cảm ơn các bạn đã theo dõi! Blog này hơi dài một chút, mong các bạn thông cảm 😅.
Chúng ta đã đi từ bối cảnh Machine Learning và các phương pháp ensemble, nhận diện hạn chế của Decision Tree, Random Forest, và AdaBoost, đến việc khám phá cơ chế Gradient Boosting:
Hiểu rõ cách Gradient Boosting cập nhật dự đoán từng cây dựa trên gradient.
Minh họa chi tiết bằng tính toán tay, bảng dữ liệu mẫu, giúp trực quan hóa quá trình huấn luyện.
Triển khai code Python, kết hợp lý thuyết và thực hành để thấy cách mô hình học từ dữ liệu.
Nhờ đó, bạn không chỉ nắm vững nguyên lý, mà còn có thể thực hành và triển khai Gradient Boosting trên dữ liệu thực tế. Đây sẽ là nền tảng vững chắc trước khi đi sâu vào XGBoost và các cải tiến nâng cao trong các bài tiếp theo.
Bài blog trên được chuẩn bị bởi các thành viên team GRID002-AOI2025.
Nếu bạn có câu hỏi hoặc muốn trao đổi thêm, mình để email đây nhé: nguyenthanhvinh07052005@gmail.com